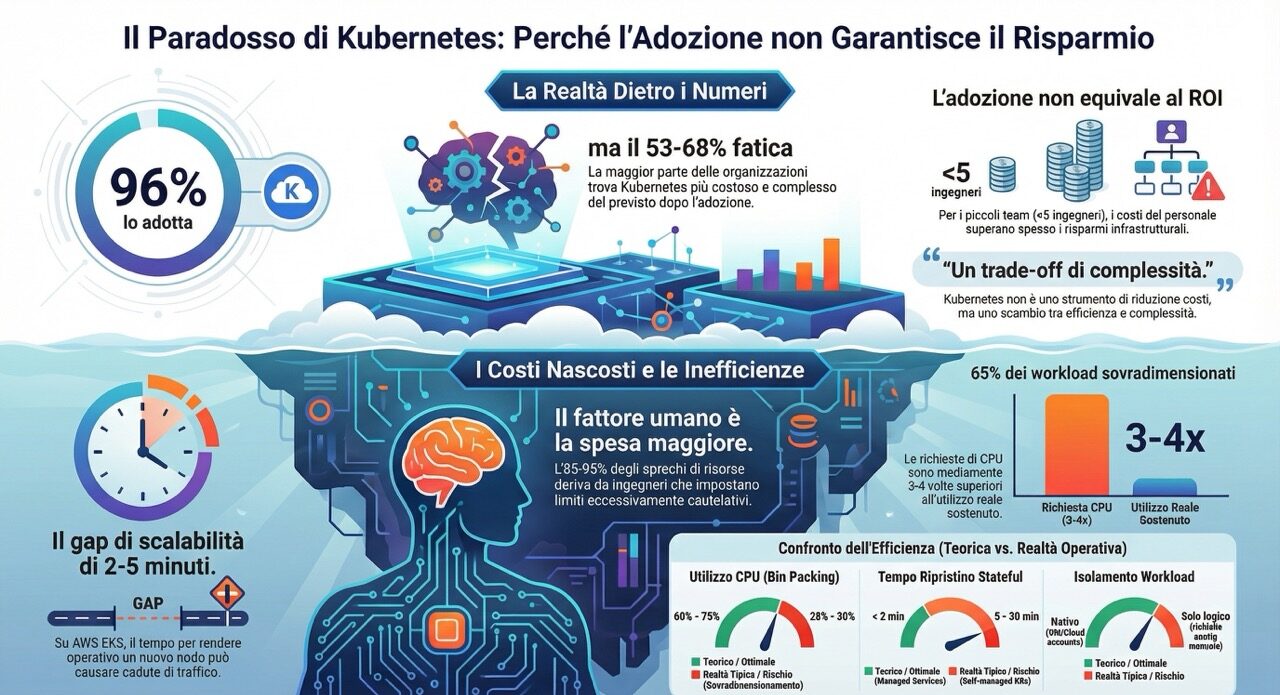

Kubernetes è un po’ come quell’attrezzo da cucina ultra-professionale che comprate convinti di diventare chef stellati, per poi scoprire che è difficilissimo da pulire e vi occupa tutto il bancone.
Oggi parliamo di un paradosso: secondo una recente stima, quasi il 96% delle aziende (dato del Cloud Native Computing Foundation (CNCF) del 2023) usa o sta valutando Kubernetes, rendendolo praticamente lo standard universale per l’infrastruttura. Eppure, la maggior parte di queste stesse organizzazioni (tra il 53% e il 68%) ammette che è molto più complesso e costoso di quanto si aspettasse. Ma com’è possibile che uno strumento nato per ottimizzare le risorse finisca per mangiarsele?
Il “peccato originale”: La scala di Google
Dobbiamo ricordarci da dove viene Kubernetes. È il discendente diretto di Borg e Omega, i sistemi interni che Google usava per gestire decine di migliaia di macchine. È stato progettato per risolvere problemi di scala che il 99% delle aziende non avrà mai. L’architettura stessa di Kubernetes dà per scontate cose come team enormi e maturità operativa estrema, che però non scalano bene verso il basso.
Il mito del risparmio energetico (e di soldi)
Sulla carta, Kubernetes è un genio del “bin packing”: riesce a sfruttare i server al 60-75%, contro il misero 20-30% delle macchine virtuali tradizionali. Bene! Peccato che la realtà ci dica altro. Secondo i dati di Datadog del 2023, oltre il 65% dei carichi di lavoro è sovradimensionato. Spesso le risorse richieste (CPU requests) sono impostate da 3 a 4 volte più alte rispetto a quanto effettivamente consumato.
La cosa curiosa è che lo spreco non è colpa del software. Solo il 5-15% dello spreco deriva dal “control plane” (il cervello del sistema); il restante 85-95% è dovuto al comportamento umano. Gli ingegneri, per paura che le app crashino, impostano limiti conservativi e non li ricontrollano più.
I costi nascosti: Persone e “Lag”
Il costo più grande non è la bolletta del cloud, ma le persone. Gestire Kubernetes in produzione richiede esperti che sappiano cosa fare quando un log di consenso etcd fallisce o una network policy blocca il traffico silenziosamente. Formare o assumere questi talenti costa caro, e per un team piccolo questo può distruggere completamente il ritorno sull’investimento (ROI).
E poi c’è la questione dell’autoscaling. Molti pensano che sia istantaneo, ma su piattaforme come AWS EKS, aggiungere un nuovo nodo può richiedere da 2 a 5 minuti*. Se avete un picco improvviso di traffico (un “momento virale” o una svendita lampo), in quei minuti i vostri utenti vedranno solo errori perché la capacità non è ancora arrivata.
*Tempo riportato ufficialmente nelle linee guida operative di AWS EKS (Amazon Elastic Kubernetes Service).
Quando vale davvero la pena?
Non fraintendetemi: Kubernetes non è il “cattivo” della storia. È uno strumento potentissimo, ma dipende tutto dalla scala. Se avete centinaia di microservizi stateless e un team dedicato alla piattaforma, i conti tornano. Ma se siete un team piccolo come il 95% delle aziende italiane, potreste finire come 37signals, che abbandonando Kubernetes ha risparmiato 1,5 milioni di dollari all’anno.
Prima di tuffarvi, chiedetevi: quanti ingegneri ho pronti a svegliarsi alle 2 di notte per debuggare un cluster? Il mio traffico ha picchi improvvisi o crescite graduali?
Kubernetes è un compromesso tra flessibilità e complessità. Assicuratevi solo che sia un compromesso che potete permettervi.
Scopri di più da Walter's blog
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.